Корпоративные системы на базе больших языковых моделей уже применяются не только для подготовки текстов. Они помогают искать информацию в документах, сопоставлять требования, формировать черновики инструкций и работать с внутренней базой знаний. В энергетике такой сервис должен решать эти задачи без передачи чувствительных данных во внешнее облако.
Исходная задача
За годы работы у энергетической компании накопился большой массив внутренних документов: инструкции, положения, технологические регламенты, методики, шаблоны, отчёты и архивные редакции. Объём базы исчислялся тысячами страниц.
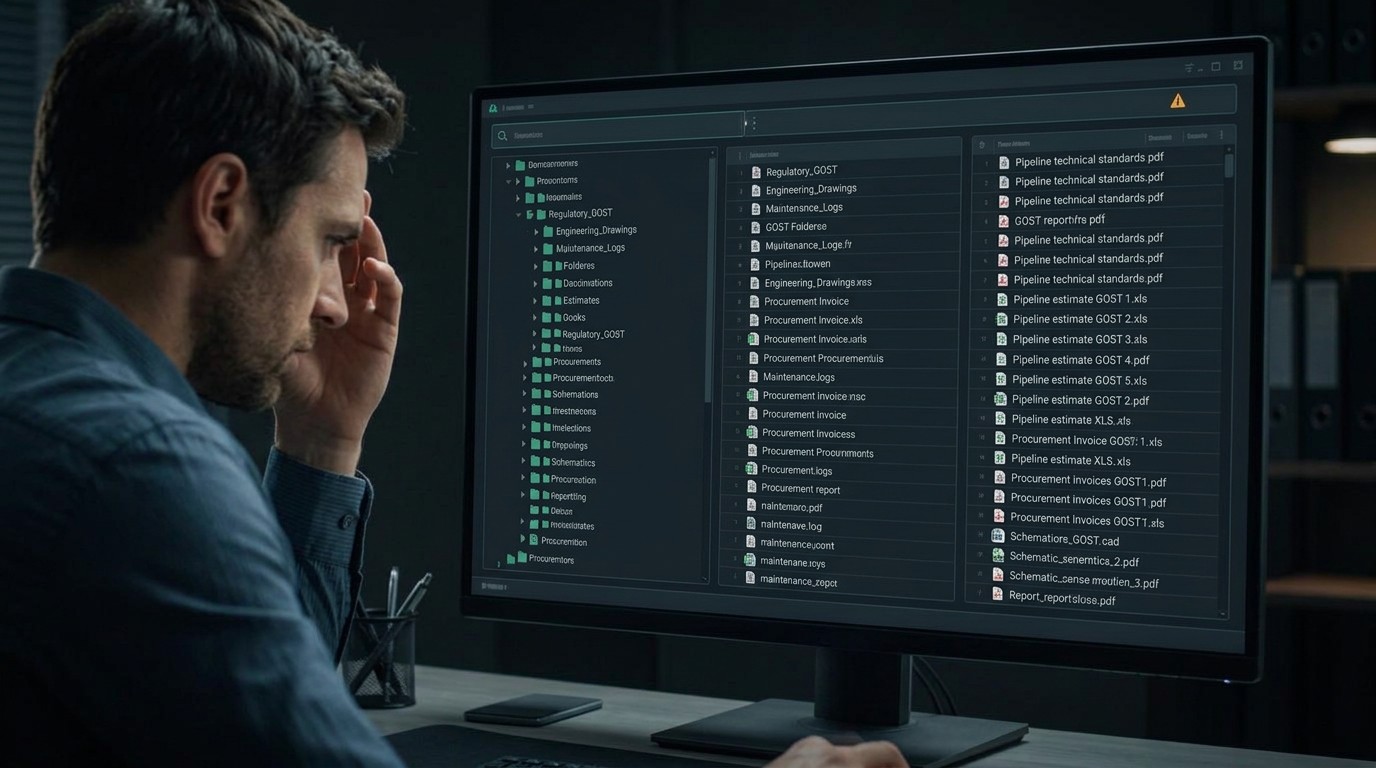
Документы создавались в разные периоды, хранились в нескольких системах и частично дублировали друг друга. Один термин мог использоваться в разных значениях, а актуальную редакцию не всегда удавалось определить по названию файла.
Для поиска конкретной нормы сотрудникам приходилось последовательно просматривать десятки файлов.
Подразделения могли использовать отличающиеся версии одного регламента или инструкции.
Новые материалы собирались из старых документов, вместе с которыми переносились ошибки и устаревшие положения.
Компания не имела общего механизма выявления дублей, противоречий и документов без понятного владельца.
Обычный полнотекстовый поиск помогал только тогда, когда сотрудник точно знал нужную формулировку. Если в вопросе и документе использовались разные слова, релевантный фрагмент мог не попасть в выдачу.
Почему готового чат-бота было недостаточно
На этапе проектирования мы сравнили три подхода. Каждый из них решает отдельный класс задач, но не каждый подходит для работы с большой корпоративной базой знаний.
| Подход | Что умеет | Ограничение для проекта |
|---|---|---|
| Скрипты и RPA | Выполняют заранее определённую последовательность действий. | Плохо работают с новыми вопросами и неструктурированными документами. |
| Классический чат-бот | Отвечает на типовые вопросы по заданным сценариям. | Каждый новый сценарий требует ручного изменения логики. |
| Публичная LLM | Понимает естественный язык и формирует развёрнутые ответы. | Документы передаются внешнему сервису, а компания зависит от его правил и тарифов. |
Нам требовалась система, которая понимает смысл запроса, работает с неструктурированными данными и остаётся внутри контролируемого ИТ-контура заказчика.
Что означает суверенность LLM-сервиса
Установка модели на локальный сервер — только один элемент суверенного решения. Организация должна контролировать весь цикл обработки информации.
- исходные документы и их версии;
- место обработки запросов;
- модель и программные компоненты;
- права пользователей и администраторов;
- журналы запросов и ответов;
- обновление и откат компонентов;
- резервное копирование и восстановление;
- работу без внешней облачной платформы.
Внешний облачный сервис
- быстрый запуск без собственной вычислительной инфраструктуры;
- оплата использования по тарифам провайдера;
- зависимость от правил обработки данных и доступности платформы.
Собственный LLM-контур
- данные и журналы остаются в инфраструктуре компании;
- нет внешней тарификации за токены;
- компания отвечает за мощности, обновления, безопасность и сопровождение.
Какие задачи выполнял сервис
Первый контур охватывал операции, в которых языковая модель могла ускорить работу специалиста, не принимая за него критичных решений.
Поиск требований и положений по смыслу запроса, а не только по точному совпадению слов.
Сопоставление документов, поиск повторяющихся и противоречащих друг другу фрагментов.
Формирование основы инструкции или аналитического отчёта для последующей проверки экспертом.
Каждый содержательный вывод сопровождается ссылкой на исходный корпоративный документ.
Ответ оставался вспомогательным материалом. Окончательное решение принимал сотрудник, который мог проверить первоисточник и контекст. В энергетике языковой агент может помогать с документами, но не должен самостоятельно управлять технологическим оборудованием или заменять утверждённую процедуру.
Как устроена агентная архитектура
Одна универсальная цепочка плохо справлялась с разными типами задач. Поиск конкретной нормы, сравнение редакций и подготовка проекта инструкции требуют разных правил обработки. Поэтому решение построили по агентному принципу.
Агенты используют общую модель, но получают разные инструкции, инструменты и ограничения. Отдельный сценарий можно развивать без перестройки всего сервиса.
Технологический контур
В основе решения использовалась открытая генеративная модель семейства Qwen размером 8B. Она подходила для локального размещения и работы с русскоязычными корпоративными документами.
Система была разделена на микросервисы: загрузка и обработка документов, извлечение текста, разметка метаданных, построение векторных представлений, поиск, повторное ранжирование, генерация ответа, управление доступом и журналирование. Такое разделение упростило сопровождение и позволило независимо развивать поиск, модель и интерфейс.
Как формируется ответ
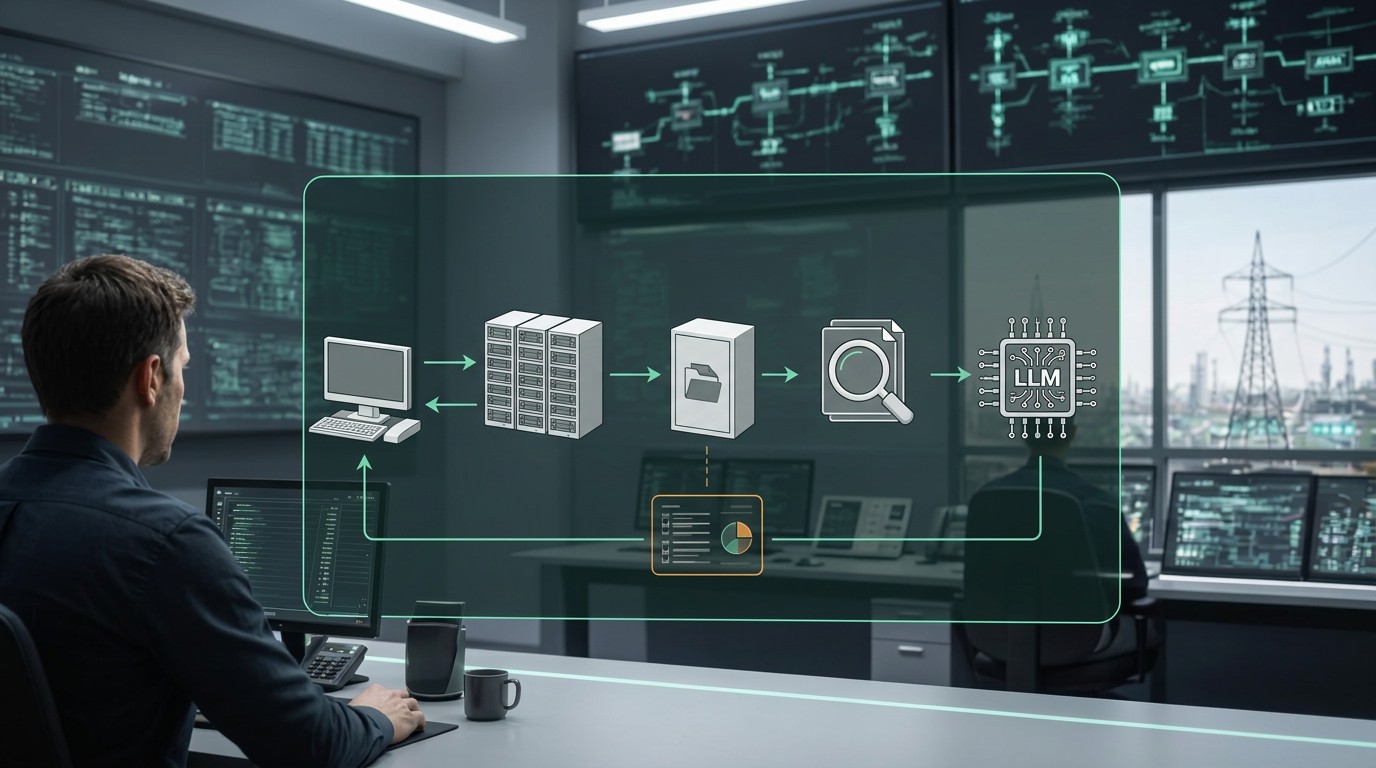
Центральным элементом решения стала технология RAG — генерация ответа с использованием найденных фрагментов корпоративной базы знаний.
Система извлекает текст, очищает его от технического мусора и разбивает на смысловые фрагменты.
К фрагментам добавляются тип документа, подразделение, дата, редакция и права доступа; затем создаются векторные представления.
Поисковый контур находит подходящие материалы с учётом формулировки запроса и разрешений пользователя.
Реранкер повторно оценивает найденные фрагменты и передаёт модели наиболее релевантный контекст.
Модель формирует ответ, а пользователь получает возможность сразу открыть использованный первоисточник.
RAG снижает вероятность неподтверждённого ответа, но не исключает ошибку. Критичный вывод должен оставаться проверяемым человеком и связанным с конкретным документом.
Почему одного семантического поиска недостаточно
Основные сложности возникли при работе с отраслевой терминологией. Энергетические документы содержат сокращения, технические обозначения и стандартные обороты. Важное различие иногда определяется номером оборудования, классом напряжения или контекстом конкретного процесса.
Находит близкие по смыслу формулировки, даже если пользователь не воспроизвёл термин из документа дословно.
Сохраняет точность при работе с кодами, номерами, аббревиатурами и специальными обозначениями.
Повторно оценивает выдачу и поднимает фрагменты, которые лучше соответствуют смыслу конкретного вопроса.
Подготовка базы знаний
Если без отбора загрузить все накопленные файлы, модель получит одновременно действующие, архивные и противоречащие друг другу материалы. Поэтому до запуска необходимо привести документы в управляемое состояние.
- назначить владельцев документов;
- отделить действующие редакции от архивных;
- удалить технические дубли;
- проверить распознавание сканов;
- зафиксировать даты и версии;
- настроить категории и метаданные;
- установить права доступа;
- описать публикацию новой редакции.
Как учитывались права доступа и безопасность
Корпоративная поисковая система не должна показывать сотруднику сведения, которых он не видит в исходной системе. Ограничения необходимо применять до передачи найденного контекста языковой модели. Если скрыть ссылку только после генерации, закрытая информация уже может повлиять на содержание ответа.
Поиск учитывает учётную запись, роль, подразделение, категорию документа, уровень конфиденциальности и срок действия разрешения.
Запросы, источники и ответы фиксируются для анализа ошибок, расследования спорных ситуаций и выявления попыток обхода ограничений.
Сегментация, защищённые каналы, обновление компонентов, резервирование и контроль привилегированных действий остаются обязательными.
В первом контуре агент ищет и подготавливает материалы, но не управляет технологическими объектами и не принимает обязательных решений.
Какие требования необходимо учитывать
Если сервис обрабатывает персональные данные, необходимо учитывать требования 152-ФЗ. Для информационных ресурсов применимы положения 149-ФЗ. Развёртывание внутри собственного периметра упрощает контроль, но само по себе не подтверждает соответствие требованиям законодательства.
Для энергетической компании отдельно определяется, относятся ли организация и связанные с LLM-сервисом системы к субъектам и объектам критической информационной инфраструктуры. Не каждый корпоративный сервис автоматически становится значимым объектом КИИ: применимость требований определяется по результатам обследования и категорирования.
Помогаем определить состав объектов КИИ, провести категорирование, подготовить сведения для ФСТЭК России и проверить выполнение требований 187-ФЗ.
До подключения модели к внутренним данным также целесообразно провести аудит информационной безопасности: определить состав информации, маршруты её передачи, права пользователей и технические границы нового сервиса.
Как проходило внедрение
Проект развивался поэтапно. Мы не начинали с выбора самой крупной модели и не пытались сразу охватить все процессы компании.
Определили операции, которые занимали больше всего времени, ожидаемый результат и границы автоматизации.
Проверили форматы, версии, метаданные, качество файлов и существующие права доступа.
Сформировали реальные вопросы и ожидаемые источники, чтобы измерять качество поиска, а не субъективное впечатление от диалога.
Установили модель и вспомогательные сервисы на инфраструктуре заказчика, настроили журналирование и мониторинг.
Объединили семантический и полнотекстовый поиск, категории, фильтры и повторное ранжирование.
Небольшая группа сотрудников проверяла сервис на реальных запросах и отмечала пропуски, ошибки и неудобные сценарии.
Корректировали разбиение документов, правила поиска, инструкции агентов и формат представления источников.
Заказчик получил мониторинг, журналы запросов и средства анализа ошибок для дальнейшего развития системы.
Как оценивать качество LLM-сервиса
Фраза «модель отвечает хорошо» не подходит для промышленной эксплуатации. До пилота необходимо определить показатели, по которым будет оцениваться результат.
| Область оценки | Что измерять | Зачем |
|---|---|---|
| Поиск | Релевантность фрагментов, актуальность редакции, соблюдение прав. | Проверить качество контекста до генерации ответа. |
| Ответ | Соответствие источникам, наличие ссылок, объём ручной переработки. | Оценить практическую пригодность результата. |
| Эксплуатация | Время ответа, нагрузка, ошибки, доступность и стоимость запроса. | Понять требования к инфраструктуре и сопровождению. |
| Бизнес | Экономия времени, число повторных поисков, использование сервиса. | Подтвердить эффект внедрения, а не только работу технологии. |
До начала проекта формализованных метрик в компании не существовало, поэтому часть результатов оценивалась по фактическому сокращению времени и обратной связи пользователей. Для следующих этапов важно фиксировать исходные значения заранее.
Результаты проекта
После внедрения операции, которые раньше занимали часы, стали выполняться за несколько минут. Сотрудник мог сформулировать вопрос обычным языком, получить релевантный ответ и перейти к использованному документу.
Многочасовой поиск и первичная обработка документов сократились до нескольких минут.
Система помогла найти дубли, противоречия и материалы, актуальность которых требовала проверки.
Заказчик получил мониторинг, журналирование и инструменты анализа ошибок, а не непрозрачный экспериментальный чат-бот.
Почему отношение сотрудников влияет на результат
На старте часть пользователей воспринимала систему как угрозу своей работе или дополнительный инструмент контроля. Отношение изменилось, когда сотрудники увидели, что агент забирает наиболее трудоёмкую часть задачи — поиск, первичную сверку и подготовку черновика — но не заменяет профессиональное решение.
- объяснить границы ответственности системы;
- показать операции, которые она ускоряет;
- обучить сотрудников проверять источники;
- создать простой механизм обратной связи;
- учитывать замечания пользователей;
- закрепить окончательное решение за человеком.
Основные ошибки при внедрении корпоративной LLM
- Начинать с выбора модели. Качество документов, поиска, прав доступа и сопровождения влияет на результат не меньше количества параметров.
- Загружать все документы без отбора. Архивные и противоречивые материалы делают ответы нестабильными.
- Считать RAG защитой от любых ошибок. Ответы всё равно требуют источников, тестирования и контроля человеком.
- Путать локальное размещение с безопасностью. Внутри контура сохраняются инфраструктурные риски и угрозы неправильного доступа.
- Сразу автоматизировать критичные решения. Начинать безопаснее с поиска, сверки и подготовки материалов.
- Не определять метрики до пилота. Без исходных показателей невозможно доказать экономический эффект.
- Не назначать владельца сервиса. База знаний, модель, права и инфраструктура требуют постоянного сопровождения.
- Игнорировать пользователей. Технически работоспособный сервис может остаться невостребованным.
Что проверить до запуска
- Какие операции необходимо ускорить?
- Как измеряется их текущая стоимость и продолжительность?
- Какие документы потребуются модели?
- Кто отвечает за их актуальность?
- Есть ли в них персональные или конфиденциальные данные?
- Можно ли передавать информацию внешней платформе?
- Какие права нужны разным категориям сотрудников?
- Должен ли агент только отвечать или выполнять действия?
- Как пользователь проверит первоисточник?
- Какие ошибки считаются недопустимыми?
- Как будут тестироваться обновления модели и базы?
- Кто будет сопровождать сервис после пилота?
- Достаточно ли вычислительных мощностей?
- Как система восстановится после сбоя?
Для оценки готовности локального контура может потребоваться аудит ИТ-инфраструктуры. Он позволяет проверить вычислительные ресурсы, резервирование, мониторинг, сетевую архитектуру и процессы эксплуатации.
Вывод
Корпоративный ИИ начинает приносить пользу, когда компания связывает модель с актуальной базой знаний, ограничивает её права, показывает пользователю первоисточники и встраивает сервис в реальный рабочий процесс.
Суверенное размещение позволяет сохранить контроль над данными и снизить зависимость от внешних платформ. Одновременно компания принимает на себя ответственность за инфраструктуру, безопасность, обновления и качество работы системы.
Главными факторами успеха стали не размер модели и не количество агентов, а подготовка документов, качество поиска и готовность сотрудников использовать новый инструмент в ежедневной работе.